Qué es el desarrollo guiado por especificaciones
Seguí leyendo
Enterate del próximo post
Un mail cuando publico algo nuevo. Sin spam y te podés dar de baja cuando quieras.
Un mail cuando publico algo nuevo. Sin spam y te podés dar de baja cuando quieras.
Escribir código con un agente es rápido. Pedir algo, mirar lo que produce, corregir lo que no sirve y repetir hasta que ande: ese ciclo funciona bien las primeras veces y se vuelve costoso a medida que el sistema crece, porque cada corrección depende de que alguien note el error mirando el resultado, no de que el pedido original ya lo hubiera descartado. Esa dependencia de mirar y corregir es el punto de partida real de casi todo el mundo que empieza a trabajar con un agente, y también el límite que Spec Driven Development (SDD) intenta correr.
Cuando escribir la implementación se abarata, el costo no desaparece: se corre. Deja de estar en teclear el código y pasa a estar en dos preguntas que antes se resolvían casi solas, escribiendo despacio: qué significa que el sistema esté correcto, y cómo se comprueba que lo está. SDD es un método de trabajo que ataca esas dos preguntas de frente: usa una especificación escrita como el insumo principal de una tarea, en vez de partir directo de un pedido informal hacia el código.
Una especificación, en este sentido, no es un documento aparte que describe lo que el código ya hace. Es lo que se escribe antes, para que el código tenga que ajustarse a ella y no al revés. La diferencia parece chica pero cambia todo lo que sigue: una especificación escrita antes fija una decisión; una descripción escrita después solo la registra, y para entonces la decisión ya la tomó otra persona, casi siempre sin haberla puesto en palabras.
El contraste con pedir y corregir (a veces llamado vibe coding) no es una caricatura de un uso descuidado. Es la forma en la que se usa un agente por defecto, sin ningún paso adicional: se describe el resultado deseado con la primera frase que alcanza, se ejecuta, se mira, y lo que falta se corrige sobre la marcha. SDD no reemplaza ese ciclo por otro completamente distinto: le agrega, antes de la primera ejecución, el paso de escribir qué tiene que cumplir el resultado de forma que dos personas que lean esa frase coincidan en si se cumplió o no.
Esto no parte de desconfiar del agente ni de sus respuestas. Un agente hace exactamente lo que su entrada le permite inferir, y cuando esa entrada es un pedido de una línea, infiere el resto, y lo infiere de alguna forma, porque no puede dejar un hueco sin llenar. El problema nunca es que invente mal: es que inventa en un lugar donde nadie decidió nada todavía, y esa decisión queda tomada por default en vez de a propósito. Mover la decisión a la especificación no vuelve al agente más confiable en abstracto: le saca de encima decisiones que no le correspondían a él en primer lugar.
Cada post de esta serie construye una funcionalidad del mismo proyecto chico: una Bitácora de lecturas, una aplicación para guardar artículos que se quieren leer más tarde, etiquetarlos, marcarlos como leídos y recibir un resumen semanal. La razón de usar un solo proyecto a lo largo de toda la ruta, en vez de un ejemplo distinto por post, es que las decisiones de especificación se acumulan: la spec que un post escribe es la que el siguiente retoma, un plan técnico se apoya en una spec concreta y no en una genérica, y las tareas se referencian a cláusulas que existen de verdad.
Este primer post todavía no tiene ninguna spec previa que retomar: es el punto de partida de la serie. El tramo que le toca es, por eso, el más chico de los treinta y cinco: tomar el pedido más simple posible dentro de la Bitácora, guardar un artículo, y mostrar, sobre ese mismo pedido, la diferencia entre soltarlo sin pensar y escribirlo como especificación.
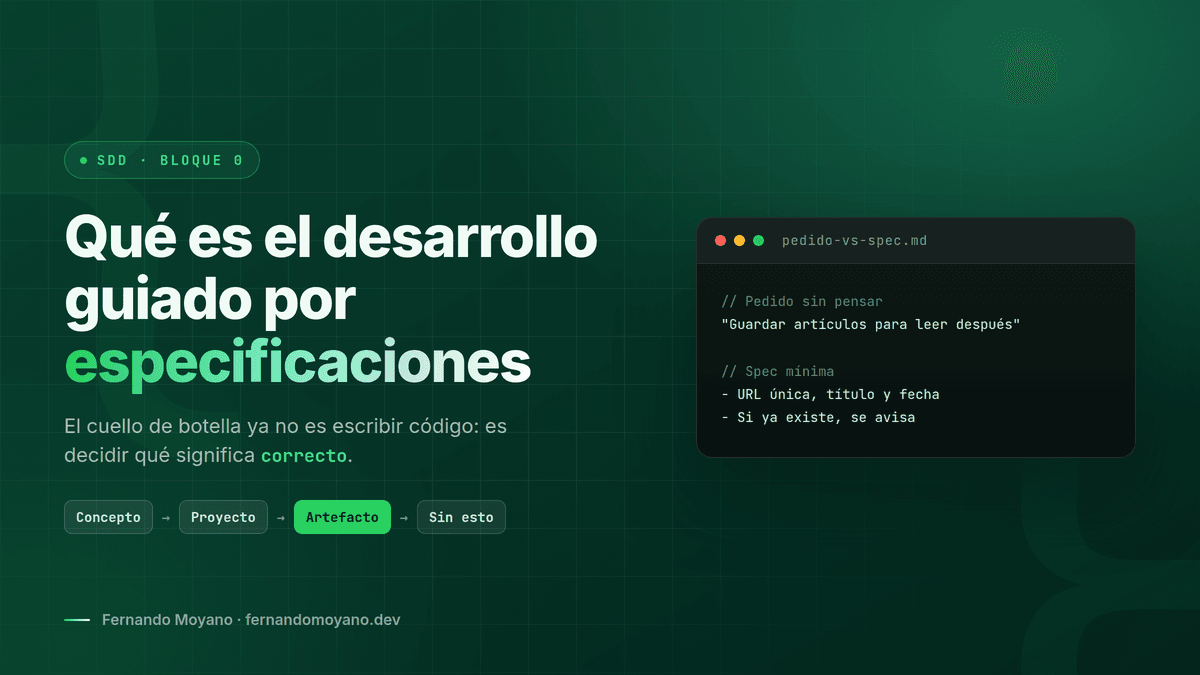
Así se le pediría a un agente sin pensarlo dos veces:
"Hacé que la app guarde artículos para leer después."
Y así se ve la misma idea escrita como una especificación mínima:
- Un artículo se guarda a partir de su URL.
- Si esa URL ya fue guardada antes, no se guarda de nuevo: se avisa que ya existe.
- Además de la URL, se guarda el título de la página y la fecha en la que se guardó.
La decisión menos obvia de las tres no es la primera, es la segunda. Guardar un artículo a partir de una URL es casi automático: cualquier lectura del pedido original ya lo asume. Pero qué pasa cuando la URL se repite es un caso que el pedido original ni siquiera menciona, y sin embargo alguien tiene que decidirlo antes de que el sistema se comporte de una forma o de otra. Escribirlo en la spec no agrega trabajo nuevo: adelanta una decisión que, sin la spec, alguien iba a tomar de todos modos, solo que sin que nadie la haya elegido a propósito.
Con el pedido original y nada más, un agente tiene que resolver ese mismo caso por su cuenta, porque el pedido no dice nada al respecto. Puede elegir guardar la URL dos veces, como dos artículos distintos. Puede elegir sobrescribir el artículo existente en silencio, perdiendo la fecha en la que se guardó la primera vez. Puede elegir devolver un error y no guardar nada. Las tres son lecturas razonables de "guardar artículos para leer después": ninguna contradice el pedido, porque el pedido no llega a rozar el caso.
El problema no es que el agente se equivoque. El problema es que, sea cual sea la opción que tome, esa elección queda escondida dentro del código, sin que nadie la haya decidido de forma consciente. Se descubre recién cuando alguien guarda dos veces el mismo artículo por error y nota, revisando el resultado, que el comportamiento no es el que esperaba, y en ese momento ya no es una decisión de diseño: es un reporte de error sobre un comportamiento que técnicamente cumple lo que se pidió.
Con un solo caso ambiguo en un pedido de una línea, el costo de revisarlo a mano todavía es bajo: alcanza con probar el sistema una vez con una URL repetida y corregir lo que haga falta. El problema crece con el tamaño del pedido, no con este ejemplo puntual: cuantas más reglas de negocio tiene una funcionalidad, más casos como el de la URL repetida quedan sin nombrar, y cada uno de ellos se resuelve por su cuenta, sin que nadie los haya puesto en la misma lista ni los haya revisado juntos.
Una especificación no es documentación adicional sobre lo que el código ya hace. Es la decisión escrita antes de que exista una implementación que la tome por otro lado.
Escribir "se guarda a partir de su URL" y escribir además qué pasa cuando esa URL se repite parece un detalle menor en un pedido de una sola línea. El próximo post de la serie separa tres capas que conviene no mezclar nunca, qué se quiere lograr, qué tiene que hacer el sistema para lograrlo, y cómo lo hace por dentro, porque buena parte de las especificaciones que fallan no fallan por cortas, sino por confundir esas tres capas entre sí.