Qué significa que un algoritmo sea mejor
Seguí leyendo
Enterate del próximo post
Un mail cuando publico algo nuevo. Sin spam y te podés dar de baja cuando quieras.
Un mail cuando publico algo nuevo. Sin spam y te podés dar de baja cuando quieras.
Entre una casa y una oficina suele haber más de un camino. Uno es el más corto en kilómetros; otro es más largo, pero va por una avenida sin semáforos. Cuál es mejor depende de si importa la distancia, el tiempo o el combustible, y aun con el criterio elegido la respuesta cambia con las condiciones: a las tres de la tarde gana el camino corto, y en la hora pico gana la avenida. Lo único que no se discute es que los dos tienen que llegar a la oficina. Uno que termina en otro barrio no compite, por más rápido que sea.
Los bloques anteriores se ocuparon de cómo resolver un problema. Este empieza a preguntarse qué tan bien se lo resuelve, y la primera pregunta es la de los caminos: qué quiere decir "mejor" cuando hay dos algoritmos para el mismo problema.
Comparar dos algoritmos solo tiene sentido si los dos son correctos: si devuelven el resultado esperado para cualquier dato de entrada válido. Un algoritmo rápido que a veces se equivoca no es más eficiente: no resuelve el problema.
Entre algoritmos correctos, "mejor" necesita un criterio explícito. Los tres habituales son el tiempo que tarda en terminar, la memoria adicional que necesita mientras se ejecuta y la claridad con la que se lee y se modifica. Rara vez hay un ganador en los tres a la vez. Este post se concentra en el tiempo.
Medir el tiempo en segundos parece lo natural, pero los segundos dependen de cosas ajenas al algoritmo: la computadora, el lenguaje, los otros programas abiertos en ese momento. Lo que sí se mantiene igual en cualquier máquina es la cantidad de pasos: cuántas operaciones básicas (una suma, una comparación, una asignación) ejecuta. En la práctica alcanza con contar la operación que más se repite, que casi siempre es la que está adentro de un bucle; las que se ejecutan una sola vez son un puñado fijo que no cambia la comparación.
Esa cantidad de pasos casi nunca es un número fijo: depende del tamaño de la entrada, que en una lista es su cantidad de elementos. Por eso la pregunta útil no es cuántos pasos da un algoritmo para una lista puntual, sino cómo cambia esa cuenta cuando la lista crece: si se queda igual, si crece en la misma proporción que la lista o si crece todavía más rápido. Un algoritmo puede ganar con cinco elementos y perder por mucho con diez mil.
A veces importa también el contenido: buscar un valor en una lista puede terminar en el primer elemento o recién en el último. Esos dos extremos se llaman mejor caso y peor caso. Para comparar se suele mirar el peor, porque es una garantía: ninguna entrada de ese tamaño va a tardar más.
El post de bucles (post 6) sumó los primeros números naturales hasta una cantidad dada con un bucle definido.
algoritmo sumar_primeros(cantidad):
    repetir contador desde 1 hasta cantidad:
        sumar contador al total
    devolver el total
Hace una suma por vuelta: 4 sumas con cantidad en 4, un millón con cantidad en un millón. El mismo problema tiene otra solución que no recorre nada. Si se escriben los números del 1 al 4 en una fila y debajo los mismos números al revés, cada columna suma 5 (1 + 4, 2 + 3, 3 + 2, 4 + 1). Hay 4 columnas, así que las dos filas juntas suman 4 × 5 = 20, y una sola fila es la mitad: 10. En general, la cantidad multiplicada por la cantidad más uno, dividido 2.
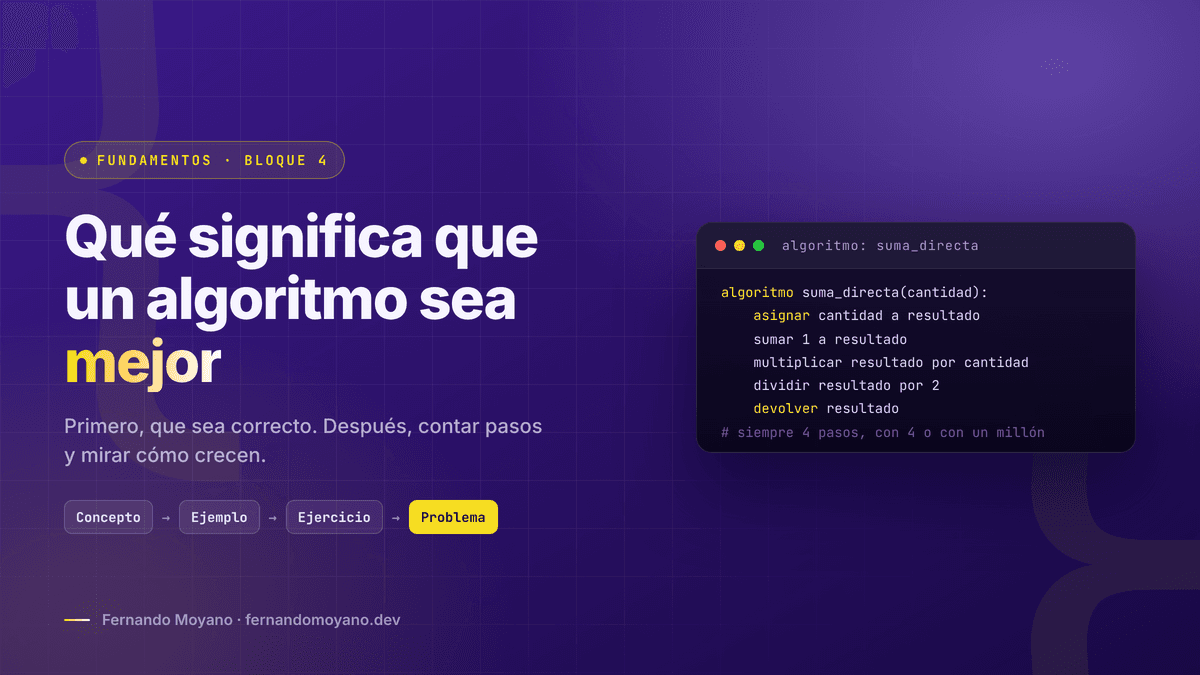
algoritmo suma_directa(cantidad):
    asignar cantidad a resultado
    sumar 1 a resultado
    multiplicar resultado por cantidad
    dividir resultado por 2
    devolver resultado
Con cantidad en 4: resultado pasa por 4, 5, 20 y 10, el mismo valor que devuelve sumar_primeros(4). Los dos son correctos, así que se pueden comparar. Contando las operaciones de cálculo:
| cantidad | sumar_primeros | suma_directa |
|---|---|---|
| 1 | 1 | 4 |
| 4 | 4 | 4 |
| 100 | 100 | 4 |
| 1000000 | 1000000 | 4 |
suma_directa hace siempre 4 operaciones, sin importar el número que reciba. sumar_primeros hace tantas como indique cantidad. Con 1, 2 o 3, el bucle hace menos operaciones; en 4 empatan; de ahí en adelante, suma_directa gana por una diferencia que no deja de crecer. El resultado de la comparación cambia con el tamaño de la entrada, y lo que decide es la tendencia, no un caso suelto.
El criterio de claridad tira para el otro lado: sumar_primeros se entiende con solo leerlo, y suma_directa necesita la explicación de las dos filas. Otra razón para nombrar el criterio antes de decir "mejor".
Un local guarda en una lista los códigos de los productos que tiene en stock. Escribir un algoritmo esta_en_stock que reciba esa lista y un código, y devuelva verdadero si el código está en la lista, dejando de buscar apenas lo encuentra. Después, contar cuántas comparaciones hace en el mejor caso y en el peor caso con una lista de 8 códigos.
Pista: un bucle definido recorre siempre la lista completa. Para poder detenerse antes, la condición del bucle tiene que mirar dos cosas a la vez: si quedan posiciones por revisar y si el código ya apareció.
algoritmo esta_en_stock(codigos, buscado):
    asignar falso a encontrado
    asignar 1 a posicion
    mientras no encontrado y posicion es menor o igual a la cantidad de elementos de codigos:
        si el elemento en la posición posicion de codigos es igual a buscado:
            asignar verdadero a encontrado
        sumar 1 a posicion
    devolver encontrado
Con codigos en ["A12", "B07", "C33", "D41", "E05", "F18", "G29", "H64"]: buscar "A12" hace una sola comparación, porque encontrado pasa a verdadero en la primera vuelta y el mientras no da una segunda; ese es el mejor caso. Buscar "H64" hace 8, una por posición. Buscar "Z99", que no está, también hace 8: tiene que revisar todas las posiciones antes de poder afirmar que no está. El peor caso, entonces, es tanta comparación como elementos tenga la lista, y con mil códigos serían mil. El mejor caso depende de la suerte; el peor es lo que se puede prometer.
Un taller recibe inscripciones por un formulario, y cada inscripción se guarda en una lista con el número de documento de quien se anotó. Antes de cerrar la lista, hace falta saber si alguien se anotó dos veces. La forma más directa es comparar cada inscripción con todas las que vienen después. Escribir esa versión, escribir otra cuya cantidad de pasos crezca más despacio a medida que crece la lista, y comparar las dos para 5, 100 y 1000 inscripciones.
Pista: comparar contra todas las posiciones siguientes repite trabajo, porque cada documento se vuelve a mirar una vez por cada uno de los anteriores. Alguna estructura ya vista en la serie responde si un valor está presente sin recorrer sus elementos uno por uno.
algoritmo repetidos_por_pares(documentos):
    asignar falso a hay_repetido
    asignar la cantidad de elementos de documentos a ultima
    restar 1 a ultima
    repetir posicion desde 1 hasta ultima:
        asignar posicion a inicio
        sumar 1 a inicio
        repetir otra desde inicio hasta la cantidad de elementos de documentos:
            si el elemento en la posición posicion de documentos es igual al elemento en la posición otra de documentos:
                asignar verdadero a hay_repetido
devolver hay_repetidoalgoritmo repetidos_con_conjunto(documentos):
asignar falso a hay_repetido
asignar un conjunto vacío a vistos
repetir posicion desde 1 hasta la cantidad de elementos de documentos:
asignar el elemento en la posición posicion de documentos a actual
si vistos contiene actual:
asignar verdadero a hay_repetido
sino:
agregar actual a vistos
devolver hay_repetidoCon documentos en ["30111222", "28444555", "31999000", "28444555", "27666333"], las dos devuelven verdadero: "28444555" aparece en las posiciones 2 y 4. repetidos_por_pares llega a esa respuesta con 10 comparaciones (4 + 3 + 2 + 1), y repetidos_con_conjunto con 5 preguntas al conjunto, una por documento, porque el conjunto responde la presencia sin recorrer su contenido (post 11).
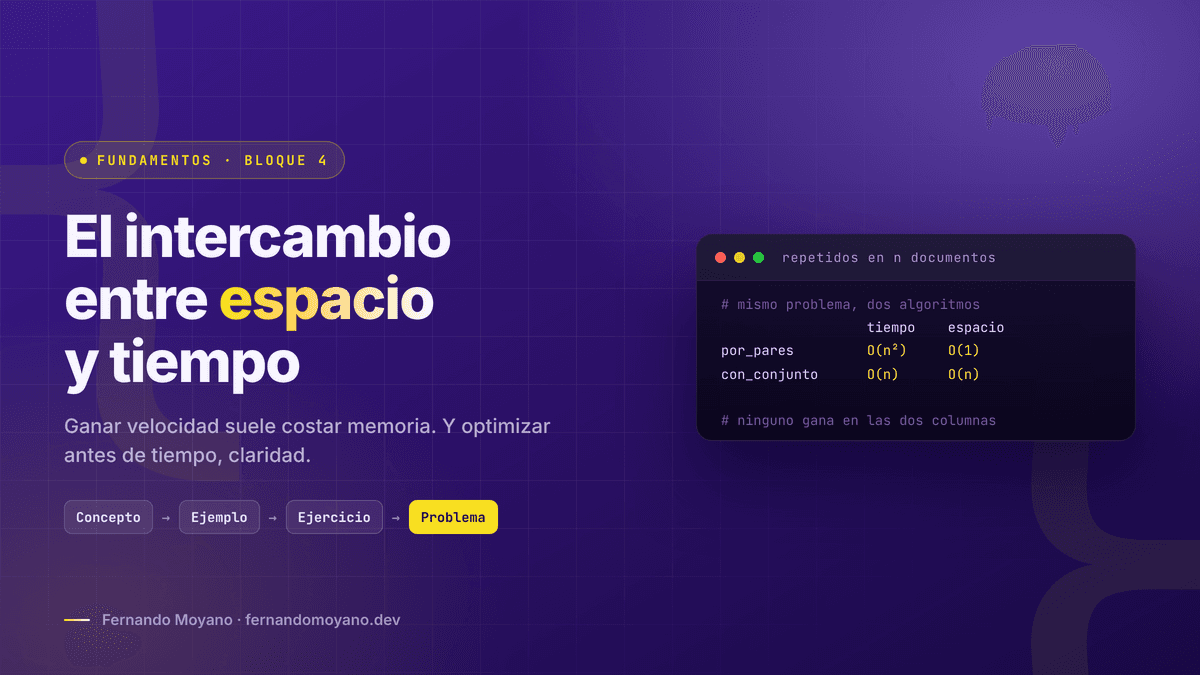
Con 5 inscripciones, 10 contra 5 parece poco. Con 100, son 4950 comparaciones contra 100 preguntas; con 1000, 499500 contra 1000: quinientas veces más trabajo para la misma respuesta. Cada inscripción nueva le suma a la versión por pares una comparación por cada inscripción anterior, y a la otra, una sola pregunta. La versión con conjunto no es gratis: guarda en vistos una copia de casi todos los documentos, memoria que la versión por pares no necesita. Ese intercambio entre espacio y tiempo tiene su propio post más adelante en este bloque.
Decir que un algoritmo es mejor que otro exige dos cosas antes de cualquier número: que los dos sean correctos y que el criterio esté nombrado. Para el tiempo, el criterio que no depende de la máquina es contar pasos, y lo que decide la comparación no es la cuenta para un dato puntual, sino cómo crece esa cuenta cuando crece la entrada, mirando el peor caso.
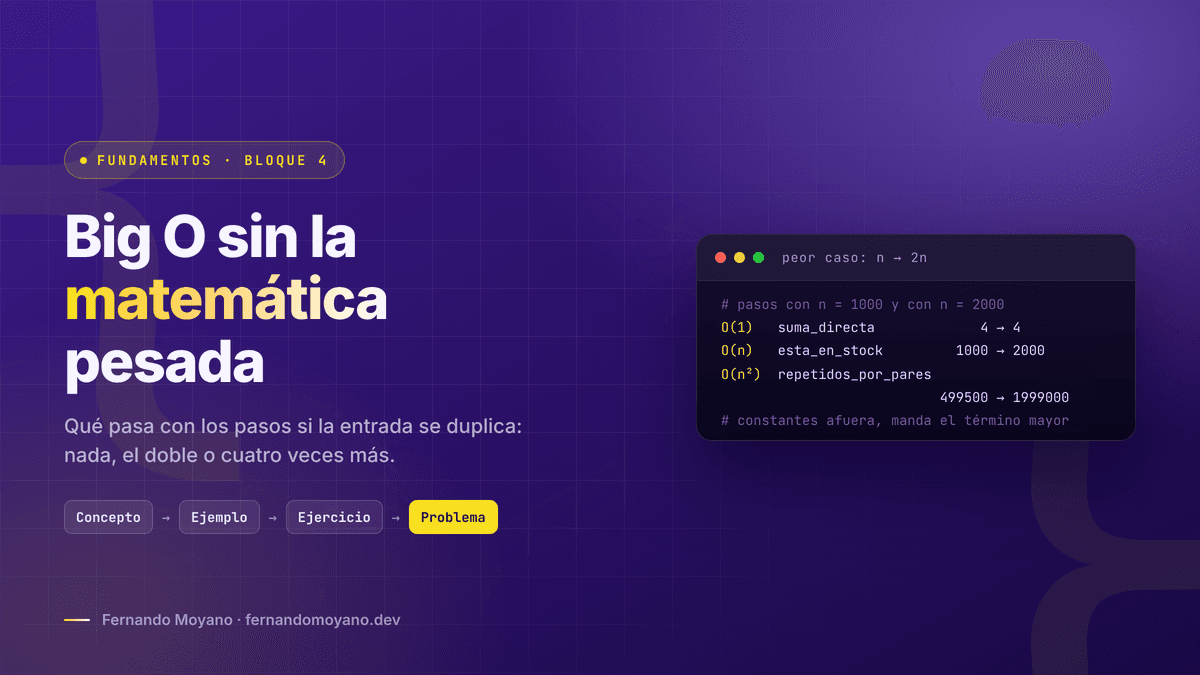
El próximo post le pone nombre a esas formas de crecer que aparecieron acá, quedarse fija, crecer en proporción a la entrada o crecer mucho más rápido que ella, con una notación pensada para eso: Big O, sin la matemática pesada.